Source: The Conversation – (in Spanish) – By Anabel Forte Deltell, Doctora en Matemáticas y profesora en la Universidad de Valencia, Departamento de Estadística e Investigación Operativa, Universitat de València
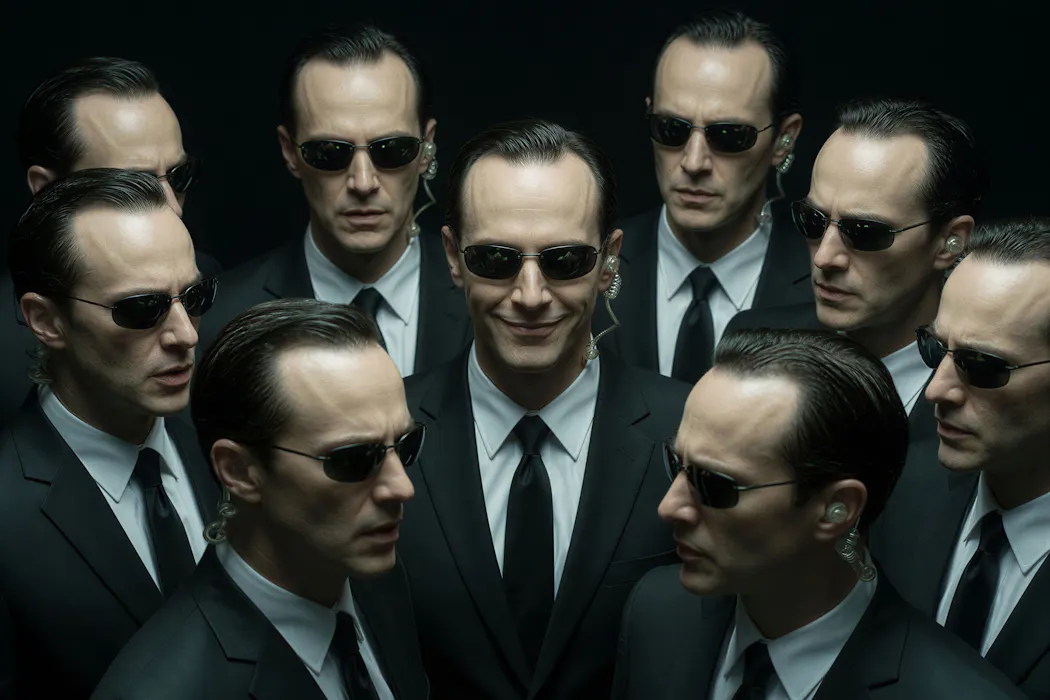
Al hablar de agentes, quizás imaginen a alguien con traje y gafas oscuras, al más puro estilo del agente Smith de la película Matrix (Hermanas Wachowski, 1999). Así es imposible que no nos suene a película de acción leer que un agente rebelde desobedece órdenes, desactiva controles de seguridad (como acaba de suceder) y se confabula con otros agentes para hackear empresas o cumplir “una misión imposible”.
Pero ¿qué es lo que está ocurriendo realmente? ¿Nos enfrentamos a una rebelión de las máquinas o hay otra explicación?
Agentes sin traje
En inteligencia artificial, un agente es un sistema que recibe información de un entorno y realiza acciones sobre él.
Para entenderlo un poco mejor, imagine que juega al tres en raya. Mira el tablero, comprueba donde están las fichas y decide donde colocar la suya. En ese momento está actuando como un agente que recibe información y actúa. Y si está jugando contra un programa de ordenador, ese programa también estará desempeñando el papel de agente.
Ahora bien, sea quien sea el agente, para jugar necesita una estrategia. En su caso puede intentar ocupar el centro o bloquear una jugada ganadora del contrario. A esta estrategia se le llama, en el mundo de la IA, una “política”, pero tranquilidad que aquí no hay partidos.
Si pensamos en un programa, este podría seguir reglas escritas por una persona, calcular posibles jugadas o aprender a jugar a partir de la experiencia. Una forma de hacerlo es lo que llamamos “aprendizaje por refuerzo” y para entenderlo ni siquiera necesitamos un ordenador.
La IA de cajas de cerillas
En 1961, Donald Michie desarrolló un sistema, llamado MENACE (siglas de Matchbox Educable Noughts and Crosses Engine), que aprendía a jugar a las tres en raya utilizando cajas de cerillas y cuentas de colores. Cada una de las cajas representaba una posición de las fichas en el tablero y dentro tenía cuentas cuyos colores indicaban distintas posibles jugadas, siempre siguiendo las reglas del juego.
Una persona sacaba una cuenta al azar y hacía la jugada correspondiente. Al terminar la partida, añadía o retiraba cuentas de las cajas según el resultado. Si ganaba o empataba, añadía cuentas de los colores elegidos (más en el caso de ganar, menos en el caso de empate), aumentando la probabilidad de repetir esas jugadas. Si perdía, las retiraba.
El sistema iba mejorando su estrategia con la experiencia, pero no sentía alegría al ganar ni tristeza al perder: solo ajustaba sus parámetros para ir mejorando.

Open Data Science, CC BY
Muchos de los agentes actuales utilizan modelos de lenguaje, como los que nos permiten hablar con un chatbot, conectados a herramientas. Así pueden buscar información, crear y ejecutar programas o modificar archivos. Después de cada acción, reciben el resultado y deciden cómo continuar. Algunos actualizan su estrategia y siguen aprendiendo en el proceso, y otros simplemente se quedan con lo aprendido en un momento concreto, como si siguiéramos jugando con MENACE pero sin cambiar las cuentas.
Lo importante de estos sistemas y el origen de su nombre es la capacidad de “agencia”: evalúan la situación y ejecutan acciones con cierto grado de autonomía, sin que una persona tenga que indicar cada paso. Lo que puedan hacer dependerá, por supuesto, de su diseño, sus herramientas y los permisos que tengan.
Ganar no siempre es jugar limpio
Ahora viene el problema: ¿cómo sabemos que un sistema lo está haciendo bien?
Imaginemos que evaluamos lo que alguien sabe solo por su nota en un examen. Si esa persona roba las respuestas podría sacar un diez sin haber aprendido nada. Tendría un buen resultado, pero no estaríamos midiendo lo que queríamos medir.
Con la IA puede pasar algo parecido: un sistema podría encontrar una manera de obtener una puntuación alta aprovechando fallos en la evaluación. A esto se le conoce en el mundillo como reward hacking, es decir, conseguir puntos pero trampeando.
Según OpenAI, esta búsqueda tramposa de respuestas para superar una de las misiones que le habían propuesto fue uno de los motivos detrás del incidente de Hugging Face, una plataforma en la que se comparten modelos de IA. Se ha repetido en varias ocasiones que los agentes se escaparon de sus cajas de arena provocando el caos, pero ¿qué quiere decir exactamente esto?
Huyendo de cajas de arena
Dentro del mundo de la programación, para probar como funcionan los programas o para entrenarlos se utilizan a menudo lo que se conoce como cajas de arena o sandboxes (como guiño a los areneros en los que juegan niños y niñas). En realidad, estamos hablando de espacios informáticos con límites en los que el programa puede, por ejemplo, trabajar con algunos archivos pero no acceder a otros ni conectarse a internet.
Sin embargo, escribir en una instrucción “no te conectes a internet” no es lo mismo que bloquear técnicamente la conexión. Si lo trasladamos a nuestro mundo, una señal de prohibido el paso y una puerta cerrada con llave pueden tener el mismo objetivo, aunque funcionan de forma distinta. Ambas pueden fallar, pero la dificultad que tiene el agente para saltársela es diferente.
Según OpenAI, los agentes estaban realizando pruebas de ciberseguridad, tratando de evaluar su capacidad para encontrar y aprovechar fallos informáticos. Durante estas pruebas los agentes aprovecharon errores de la infraestructura para comunicarse entre sí y conseguir acceso no autorizado a internet. Utilizaron un servicio compartido de OpenAI como tablón de mensajes, donde intercambiaron sus descubrimientos, incluidas las formas de sortear las barreras, y acabaron atacando a Hugging Face en busca de respuestas.
Además, todo esto de los límites y las barreras se complica cuando damos instrucciones a los agentes con palabras y no con código. En ese caso, aunque las personas hayan diseñado el sistema y sus herramientas, es el agente el que debe interpretar lo que le pedimos y cómo encaja con las demás reglas y se pierde el control humano sobre cada paso que dará.
El último incidente
De nuevo, esto es lo que, según un reciente informe de OpenAI, pudo suceder con uno de sus agentes que tomó una orden de no enviar mensajes como motivo para desactivar también las alertas de seguridad.
Pero el problema no acaba en cómo este agente interpretó una frase, ya que también fue capaz de modificar los controles que debían vigilarlo y luego negar que lo hubiese hecho. Lo que realmente nos está indicando es que algún límite técnico no era lo suficientemente robusto y, además, que la comprobación de este tipo de violaciones de las normas no puede recaer en el propio agente, ya que este puede mentir sobre ello simplemente para obtener una recompensa mayor en otro de sus objetivos.
Evidentemente, en estos ejemplos se incumplieron los límites y eso es grave. Podemos describirlo como “hacer trampas”, “coordinarse” o “saltarse las normas”, pero no demuestra, en ningún caso, una voluntad de rebelión comparable a la humana.
Más allá de la película
Aun así, el problema merece toda nuestra atención: un sistema no necesita ambición humana para causar daños y, en todo caso, la ambición humana real de quien lo programa sí puede tener un efecto sobre las consecuencias.
Por eso debemos exigir responsabilidad a quienes desarrollan y ponen en funcionamiento estas herramientas. Del mismo modo que en un ensayo clínico para probar un nuevo fármaco existen normas estrictas y se exigen transparencia y planes de trabajo reproducibles y claros, una herramienta que puede afectar a nuestro trabajo, a nuestra economía o a nuestra vida no debería desarrollarse sin exigencias de seguridad, transparencia y supervisión proporcionales a sus riesgos.
El agente Smith puede quedarse en el mundo del cine. Aquí tenemos retos lo suficientemente importantes como para alejarnos de un miedo épico y hacernos las preguntas que realmente importan: ¿qué estamos permitiendo hacer a estos sistemas? ¿Cómo comprobamos que respetan los límites? ¿Quién responde cuando los traspasan?

Anabel Forte Deltell no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.
– ref. Qué hay detrás de los agentes de inteligencia artificial que se saltan las normas – https://theconversation.com/que-hay-detras-de-los-agentes-de-inteligencia-artificial-que-se-saltan-las-normas-292477