Source: The Conversation – (in Spanish) – By Manuel García Fernández, Profesor Doctor. Computación y Tecnología, Universidad Europea
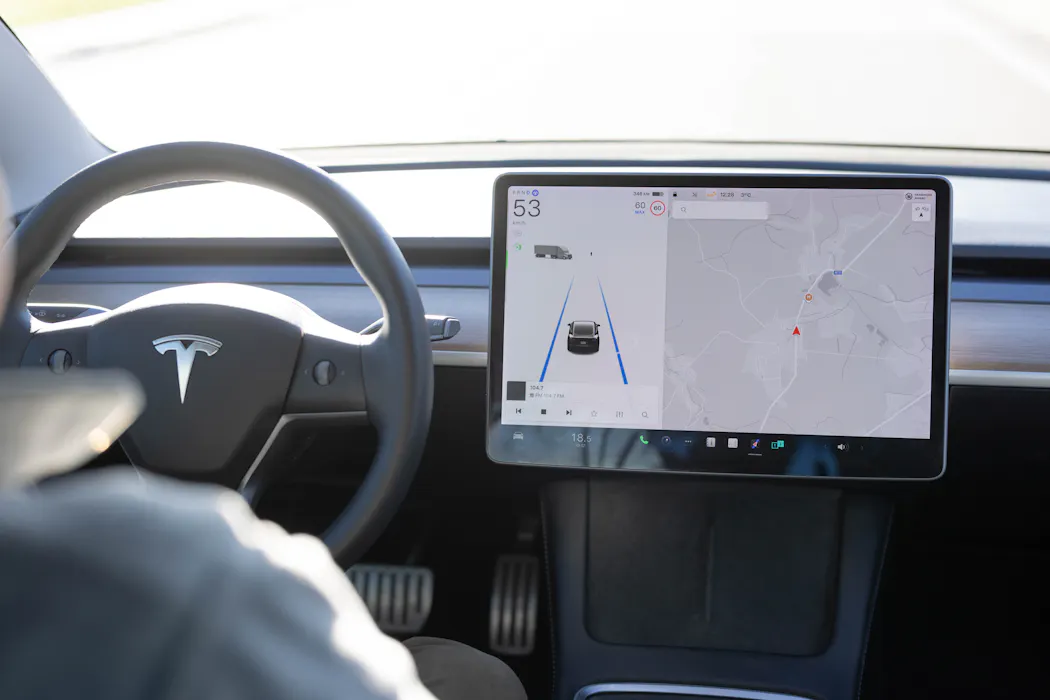
Los coches autónomos necesitan aprender a desenvolverse en un mundo extraordinariamente complejo. Una carretera en apariencia sencilla puede cambiar por completo cuando hay un vehículo detenido, unas obras, una bicicleta, un peatón o cualquier otra situación inesperada.
Una de las maneras más intuitivas de enseñar a un sistema de inteligencia artificial a enfrentarse a esta enorme variedad consiste, precisamente, en observar cómo conducimos las personas e intentar que la máquina aprenda de ello.
Para conseguirlo, necesitamos datos, muchos datos. Una forma de obtenerlos es mediante la denominada “conducción naturalista”: registrar lo que sucede mientras una persona conduce en condiciones reales o similares a las que encontramos habitualmente en la carretera. El vehículo puede incorporar cámaras y distintos sensores para observar el entorno y, simultáneamente, grabar las acciones que realiza la persona al volante.
De esta manera podemos relacionar dos elementos fundamentales: lo que estaba viendo el conductor y lo que decidió hacer en ese momento. Una cámara frontal, por ejemplo, puede observar la carretera mientras otros sensores registran las acciones realizadas sobre los controles del vehículo. Al sincronizar ambas fuentes de información, obtenemos miles de ejemplos de situaciones reales de conducción acompañadas de la reacción humana correspondiente.
Clonación del comportamiento al volante
Es aquí donde aparece una técnica conocida como behavioral cloning, o clonación del comportamiento. Su principio es bastante sencillo: enseñamos a un sistema de inteligencia artificial muchas situaciones de conducción y le mostramos qué hizo una persona en cada una de ellas. La máquina observa una situación, intenta predecir qué actuación debería llevar a cabo y compara su predicción con lo que realmente hizo el conductor. A partir de sus errores, va modificando progresivamente el modelo.
El objetivo es que, después de observar suficientes ejemplos, el sistema pueda relacionar lo que percibe con una determinada acción. En lugar de programar manualmente todas las situaciones posibles que pueden producirse en una carretera, tratamos de que el sistema aprenda directamente de ejemplos humanos.
Esto resulta especialmente atractivo porque conducir es una actividad tremendamente difícil de reducir a unas pocas reglas. La experiencia de personas reales contiene una enorme cantidad de información acerca de cómo enfrentarnos a curvas, intersecciones, otros vehículos o situaciones imprevistas.
Pero aparece inmediatamente otra dificultad: no todos conducimos igual.
Cada conductor es distinto
Dos personas pueden recorrer exactamente la misma carretera y comportarse de formas diferentes. Una puede iniciar un giro antes que otra. Algunas realizan correcciones suaves y otras actúan con mayor intensidad. También podemos reaccionar de formas diversas cuando aparece un obstáculo o cambia la situación del tráfico.
Por tanto, si queremos desarrollar sistemas autónomos capaces de adaptarse a la gran diversidad que encontramos en el mundo real, resulta interesante que puedan aprender de experiencias procedentes de muchos conductores. Cuanta mayor sea la diversidad de situaciones observadas, más oportunidades existen para aprender comportamientos que no dependan únicamente de una persona.
La solución más inmediata parece sencilla: recopilar los datos de muchos conductores, almacenarlos conjuntamente y utilizarlos como fuente de entrenamiento. Sin embargo, aquí surge un problema que trasciende la tecnología de conducción autónoma: la privacidad.
El escollo de la privacidad
Cuando hablamos de datos utilizados para entrenar inteligencia artificial, podemos pensar que se trata simplemente de imágenes y números almacenados en un ordenador. Sin embargo, pueden decir mucho sobre la persona que está al volante.
Pueden, por ejemplo, describir su estilo de conducción: cómo actúa sobre los controles, cómo reacciona ante determinadas situaciones o qué patrones repite mientras conduce. Y, si los registros contienen información de localización o permiten reconstruir los desplazamientos, su análisis continuado podría revelar también lugares frecuentados y rutinas. A partir de esos patrones, sería posible inferir información tan personal como dónde vive una persona, dónde trabaja o si tiene un problema de salud que le hace frecuentar el hospital, por ejemplo.
La cuestión cambia entonces considerablemente. Ya no estamos protegiendo solamente unas imágenes captadas por un vehículo o una serie de valores producidos por sus sensores. Estamos hablando de información que, cuando se acumula y combina, puede llegar a describir nuestros hábitos, nuestros desplazamientos y parte de nuestra vida cotidiana.
Como apuntábamos antes, para enseñar mejor a los sistemas de conducción autónoma, nos interesa disponer de experiencias procedentes de muchas personas, porque cada conductor aporta situaciones y comportamientos diferentes. Pero cuanto más centralizamos esa información, mayor importancia adquieren preguntas como quién almacena los datos, quién puede acceder a ellos, durante cuánto tiempo deben conservarse o para qué pueden utilizarse.
El verdadero reto consiste entonces en conseguir que una inteligencia artificial pueda beneficiarse de la experiencia de muchas personas sin necesitar concentrar necesariamente toda esa información en un único lugar.
Alternativa a la información centralizada
Aquí es donde entra en juego el aprendizaje federado, que cambia la manera tradicional de compartir información. En lugar de enviar los datos originales de todos los participantes a un servidor para construir un gran conjunto de entrenamiento, cada uno puede entrenar localmente una copia del modelo utilizando sus propios datos. Posteriormente, se comparte información relacionada con lo que el modelo ha aprendido y esas actualizaciones se combinan para construir un modelo común, sin necesidad de centralizar los datos originales.
La idea puede resumirse en una frase: que viaje el aprendizaje y no necesariamente los datos originales.
Además, el proceso puede repetirse sucesivamente. Los participantes aprenden de sus propios datos, contribuyen al modelo compartido y reciben de nuevo el conocimiento agregado.
Pensemos en varios conductores que circulan por lugares diferentes. Uno se encuentra frecuentemente con determinados tipos de carreteras, otro con situaciones de tráfico diferentes y un tercero experimenta circunstancias que los demás nunca han encontrado. Ninguna persona puede experimentar por sí misma todas las situaciones posibles. Sin embargo, podemos beneficiarnos del conocimiento compartido.
El aprendizaje federado traslada una idea similar al aprendizaje automático: permite que diferentes participantes contribuyan a un conocimiento común, aunque los datos de sus experiencias concretas permanezcan almacenadas en el propio vehículo.
Esto supone también una forma diferente de pensar sobre la inteligencia artificial. Durante mucho tiempo, hemos asociado mejores sistemas de IA con conjuntos de datos cada vez mayores y, por tanto, con la necesidad de recopilar enormes cantidades de información en grandes repositorios. El aprendizaje federado introduce otra posibilidad: podemos distribuir no solo los datos, sino también parte del propio proceso de aprendizaje.

Manuel García Fernández recibe fondos del Ministerio de Ciencia e Innovación, Agencia Estatal de Investigacion y la Comunidad de Madrid. El es miembro de IEEE Computational Intelligence Society.
– ref. Aprendizaje federado: el truco para que un coche autónomo aprenda de otros conductores sin violar su privacidad – https://theconversation.com/aprendizaje-federado-el-truco-para-que-un-coche-autonomo-aprenda-de-otros-conductores-sin-violar-su-privacidad-294792