Source: The Conversation – (in Spanish) – By Noelia Boza Valencia, Logopeda e investigadora predoctoral en afasia y trastornos del lenguaje, Universidad de Málaga
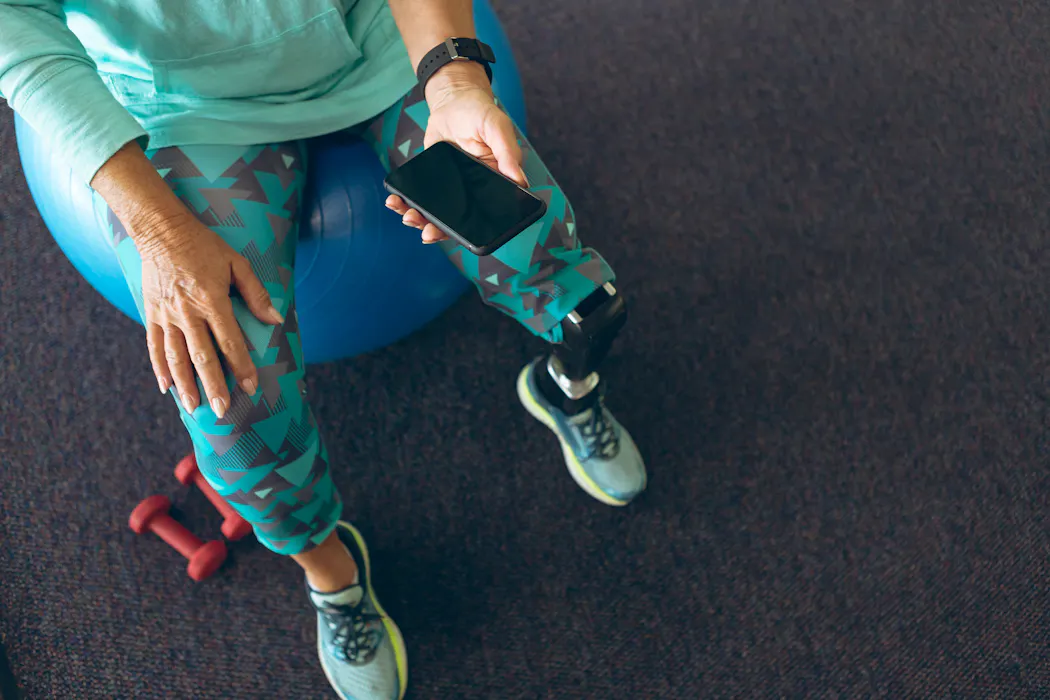
Carmela sufrió un ictus hace 5 años. Actualmente tiene 54 años y conserva buena parte de su autonomía. Sin embargo, convive con dos secuelas frecuentes tras este tipo de lesión: dificultades motoras en el lado derecho del cuerpo (hemiparesia) y problemas para hablar (afasia).
Tiene teléfono móvil, pero siente mucha frustración al utilizarlo. Escribir mensajes le resulta lento y costoso debido a sus problemas motores y, aunque buscó en el dictado por voz una posible solución, la tecnología no consigue terminar de entenderla.
Carmela quiere ir a un comercio que no sabe dónde está, aunque tiene la dirección. Pulsa el icono de Google Maps, presiona el micrófono y dice:
“Ma, Maria de Orue, ourueta, orueta, Maria de ourueta”.
Lo que Carmela quería decir era el nombre de la calle: “María de Orueta”. Sin embargo, al terminar de producir su mensaje, en la pantalla aparece la transcripción “Teorías de Google”. Debajo, Google Maps responde: “No hay resultados en Google Maps. Prueba a buscar otra cosa o en una zona diferente”.
La inteligencia artificial (IA) ha “escuchado” su voz, pero esa voz se aleja de los patrones con los que fue entrenada. En casos como este, el resultado suele ser impredecible. Dependiendo de la herramienta utilizada, el mensaje puede cortarse antes de que termine de ser producido, transcribirse parcialmente o convertirse en una secuencia de palabras sin relación con lo que se pretendía expresar.
Paradójicamente, quienes más podrían beneficiarse de las nuevas tecnologías de voz son también quienes encuentran más dificultades para utilizarlas.
Cuando el habla no es la esperada
Los sistemas de reconocimiento automático del habla (ASR, por sus siglas en inglés) mediante IA están presentes en teléfonos móviles, asistentes virtuales y aplicaciones de mensajería. Herramientas como Siri, Alexa, Google Speech-to-Text, el teclado virtual G-Board o los callbots –agentes virtuales de voz para llamadas– permiten dictar mensajes, realizar búsquedas o interactuar con diferentes dispositivos mediante la voz.
Estos sistemas aprenden a partir de ingentes cantidades de grabaciones del habla humana, que proceden de personas sin alteraciones del lenguaje o del habla. Durante su entrenamiento, utilizan algoritmos de aprendizaje profundo (Deep Neural Networks o DNN) para identificar patrones y relaciones entre los sonidos y las palabras. Y cuantos más ejemplos reciben, mejor suelen funcionar.
Sin embargo, esa eficacia no siempre se mantiene cuando el habla se aleja de los patrones considerados habituales. Ocurre, por ejemplo, en personas con trastornos adquiridos del lenguaje, como la afasia, o con enfermedades neurodegenerativas que afectan a la comunicación. También pasa en personas con trastornos del neurodesarrollo, como la disfemia o el trastorno del desarrollo del lenguaje.
En estos casos, la precisión puede disminuir de forma considerable, ya que el sistema de IA se enfrenta a producciones atípicas que están infrarrepresentadas dentro del corpus con el que ha sido entrenado.
La afasia: encontrar las palabras
Se estima que, solo en España, alrededor de 350 000 personas conviven con el trastorno adquirido del lenguaje que padece Carmela, la afasia. Suele aparecer tras lesiones cerebrales como un ictus, un traumatismo craneoencefálico o un tumor cerebral.
Dependiendo del perfil clínico, el habla de las personas afectadas puede presentar dificultades en la fluidez (por ejemplo, “ca… ca… caja”); problemas para encontrar palabras (“esto es, es en el, en el… es un lago”); errores fonológicos que sustituyen o alteran sonidos dentro de una palabra (“tededo” en lugar de “tenedor”); errores semánticos que expresan una palabra relacionada en lugar de la que se pretendía (“lámpara” en lugar de “linterna”) y dificultades morfosintácticas (“el niño juegan”).
Por supuesto, estas producciones incorrectas no reflejan una falta de inteligencia ni de intención comunicativa. Habitualmente, la persona sabe lo que quiere decir, pero encuentra obstáculos para expresarlo oralmente de forma correcta.
Un interlocutor humano suele adaptarse a estas dificultades y acabar comprendiendo el mensaje. Los sistemas automáticos, en cambio, no siempre lo consiguen.
¿Transcribir o interpretar?
Para ilustrar estas limitaciones, en el Laboratorio de Lenguaje y Cognición Numérica de la Universidad de Málaga presentamos producciones verbales de dos pacientes de afasia –a los que hemos llamado Miguel y Juan– a diferentes transcriptores de voz a texto y asistentes virtuales. Los resultados muestran patrones de errores diferentes, relacionados con la arquitectura interna de estos sistemas: ausencia de transcripción, sustitución de palabras clave y respuestas ajenas al mensaje original, en ocasiones, incluso, en otro idioma.
Ante el habla de Miguel y Juan, Gboard actúa principalmente como un transcriptor. Se trata del teclado virtual de Google que incorpora funciones de dictado por voz y reconocimiento automático del habla. Su objetivo es intentar reproducir literalmente lo que detecta en la señal de audio. Cuando el mensaje es demasiado ambiguo, Gboard puede autocorregirse para generar una producción más reconocible. En cambio, con frecuencia produce una transcripción incompleta o no muestra ningún resultado.
Por el contrario, herramientas como Gemini o ChatGPT actúan parcialmente como intérpretes. En lugar de limitarse a transcribir, intentan inferir la intención comunicativa del hablante y reconstruir el mensaje.

Noelia Boza.
Estas diferencias plantean una cuestión relevante: ¿debería la tecnología reproducir exactamente lo que escucha o debería tratar de corregirlo para facilitar la comunicación? Ambas opciones tienen ventajas y riesgos.
Una transcripción literal respeta fielmente la producción del hablante y puede resultar útil en contextos clínicos o de investigación. Pero también puede generar mensajes difíciles de interpretar para familiares o interlocutores. Por el contrario, una corrección automática puede facilitar la comunicación cotidiana, aunque introduce el riesgo de modificar parcialmente el significado del mensaje original, al añadir palabras que no se querían decir o eliminar palabras de valor para el emisor.
Hacia una tecnología que escuche más voces
La falta de representación de determinados colectivos en los datos de entrenamiento constituye uno de los grandes desafíos actuales para las tecnologías del lenguaje, que no solo penalizan a las personas con dificultades en el lenguaje, sino también a aquellas que se alejan de la norma, por ejemplo, porque tienen acentos marcados o menos habituales.
En este contexto, diferentes iniciativas internacionales están trabajando para mejorar el reconocimiento de habla atípica. Proyectos como el europeo NUVOIC, Euphonia (impulsado por Google), Speech Accessibility Project (promovido por Amazon, Apple, Google, Meta y Microsoft) o la aplicación Voiceitt buscan desarrollar herramientas capaces de adaptarse a personas con alteraciones del habla y la comunicación.
La solución no pasa únicamente por desarrollar modelos computacionales más potentes: también requiere incorporar muestras representativas de habla patológica durante el entrenamiento de los sistemas de IA, diseñar sistemas capaces de adaptarse a diferentes perfiles lingüísticos y fomentar la colaboración entre ingenieros, logopedas, neuropsicólogos y lingüistas clínicos.
Comprender cómo se altera el lenguaje tras una lesión cerebral es un requisito para construir tecnologías realmente inclusivas.
Un sistema de IA diseñado para facilitar la comunicación solo será de verdad útil cuando sea capaz de comprender toda la diversidad de “voces” que forman parte de ella.

Las personas firmantes no son asalariadas, ni consultoras, ni poseen acciones, ni reciben financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y han declarado carecer de vínculos relevantes más allá del cargo académico citado anteriormente.
– ref. La inteligencia artificial no está entrenada para reconocer el habla de quien más la necesita – https://theconversation.com/la-inteligencia-artificial-no-esta-entrenada-para-reconocer-el-habla-de-quien-mas-la-necesita-284463